你的 CLAUDE.md 越写越长,agent 却越来越不听话
为什么写进上下文的规则必然静默失效,以及为什么 AI 时代需要的是确定性机器护栏

写进上下文的自然语言规则会随对话增长被稀释并静默失效,写进工具的确定性检查不会;AI 时代的工程化重点不是把 CLAUDE.md 写得更长更完美,而是少写自然语言 Prompt,把规则外化成确定性的机器护栏。
越长越礼貌的违规者
几乎每一个日常使用 Claude Code 或 Cursor 的工程师,都走过一条完全相同的规则膨胀曲线。
刚开始接触 Agent 时,配置文件里通常只有十几行:项目技术栈、启动命令、目录结构。代码跑得很顺畅。
随着交互深入,坏毛病开始冒头:Agent 随手定义了全局状态、漏掉了错误包装、顺手把业务实体塞进了持久化层,或者写出跨越 150 行的面条函数。
工程师的标准反应是加规则。发现一个问题,就在 CLAUDE.md 或 AGENTS.md 里追加一条:“严禁使用全局变量”、“函数长度不得超过 50 行”、“所有错误必须显式包装”、“必须为所有对外 API 补充边界测试”。
当这份文件从 20 行膨胀到 300 行时,诡异的现象出现了。
Agent 并不会报错,也没有拒绝你的要求。相反,它在每次回答开头表现得极其礼貌:“好的,我已完全理解项目的编码规范,接下来将严格遵循。”
随后敲出的代码,依然堂而皇之地违背你刚写下的第 47 条规则。
这是整个工程协作里最危险的形态:它不是硬性崩塌,而是静默失效。自然语言规约没有物理约束力,它退化成了加勒比海盗嘴里的法则——只是参考意见,随时可以忽略。
“模型不够聪明”是一个偷懒的借口
面对静默失效,开发者通常本能地把原因推给两处:要么抱怨当前底层大模型的推理能力不足,要么归咎于自己的 Prompt 措辞不够严谨。
于是折腾继续升级:给提示词加粗加叹号、增加严厉的负向词汇、补充大量 Few-shot 样例,甚至频繁切换到底层更昂贵的推理模型。
这完全找错了靶子。
只要你在一个没有任何历史包袱的空白会话里,单独把那条被忽略的规则喂给同一个模型,它的遵从率几乎是 100%。在干净的环境下,它完全知道如何拆解函数、如何包装错误、如何处理并发安全。
模型从来不缺理解单条规则的推理智力。
问题出在规则存放的物理位置:上下文内部的自然语言指令是会随时间衰减的消耗品,上下文外部的机器工具则永远保持冷酷。
规则在长上下文中的衰减物理学
自然语言规则为什么必然失效?这不是玄学,而是有据可查的计算物理学限制。
1. 注意力预算是一笔固定支出
Anthropic Applied AI 团队在 2025 年 9 月发布的 Context Engineering 指南中明确指出:
"Context, therefore, must be treated as a finite resource with diminishing marginal returns."
"Good context engineering means finding the smallest possible set of high-signal tokens that maximize the likelihood of some desired outcome."
大模型在处理输入时,消耗的是一份有限的注意力预算(Attention Budget)。
很多开发者误以为往系统提示里多塞一条规则,只是给 Agent “多装了一道安全锁”。事实上,输入序列里的每一个 Token 都在分摊模型的注意力权重。
当你往 CLAUDE.md 里多塞一条 50 词的格式规范,你不仅是在定义这条新规则,更是在从现存的每一条架构约束和业务上下文里,各自偷走一份注意力。
2. 位置偏差把规则推入遗忘盲区
早在 2023 年,斯坦福大学 Nelson F. Liu 等学者发表在 Transactions of the ACL(2024)的经典论文《Lost in the Middle》就揭示了一条残酷规律:
大语言模型对长上下文信息的提取能力呈现极端的 U 型分布。模型对最开头和最末尾的 Token 敏感度最高,对落入输入中间区域的内容捕捉率急剧下跌。
更重要的是,论文证实了两个常被误解的结论:位置偏差在经过充分指令微调(RLHF)后依然顽固存在;声称拥有更大上下文窗口的模型,并不会因此摆脱这种衰减。
在实际的编码会话中,工程师写在配置文件顶部的规范,随着对话推进,迅速被几万行的代码切片、目录树展开、终端输出和搜索结果向后推挤。
几轮交互过后,原本位于顶部的黄金规则,已经精准沉入 U 型曲线最底部的遗忘深渊。
3. 远在窗口耗尽前发生的上下文腐烂
许多人抱有侥幸心理:只要上下文窗口没用满,规则就还在。
Chroma Research 在 2025 年 7 月针对全球 18 个前沿商业模型(包括 Claude 3.5/3.7/4、GPT-4o/o3、Gemini 2.5、Qwen3 等)进行了长文本抗干扰横向实测。
实验给出了确凿的工程定论:Context Rot(上下文腐烂)远在触及上下文窗口物理上限之前就已经发生。
在标准的 LongMemEval 评测中,面对同一个精确检索问题,在约 300 Token 的精简上下文中,各大模型的准确率稳定在 70% 到 90%;而一旦在提示词中塞入真实的冗余上下文,模型准确率直接断崖式跌落至 30% 到 60%。
18 个前沿模型,无一例外。
每在提示词里多写一段絮絮叨叨的自然语言,你都在主动把模型推向性能腐烂的临界点。
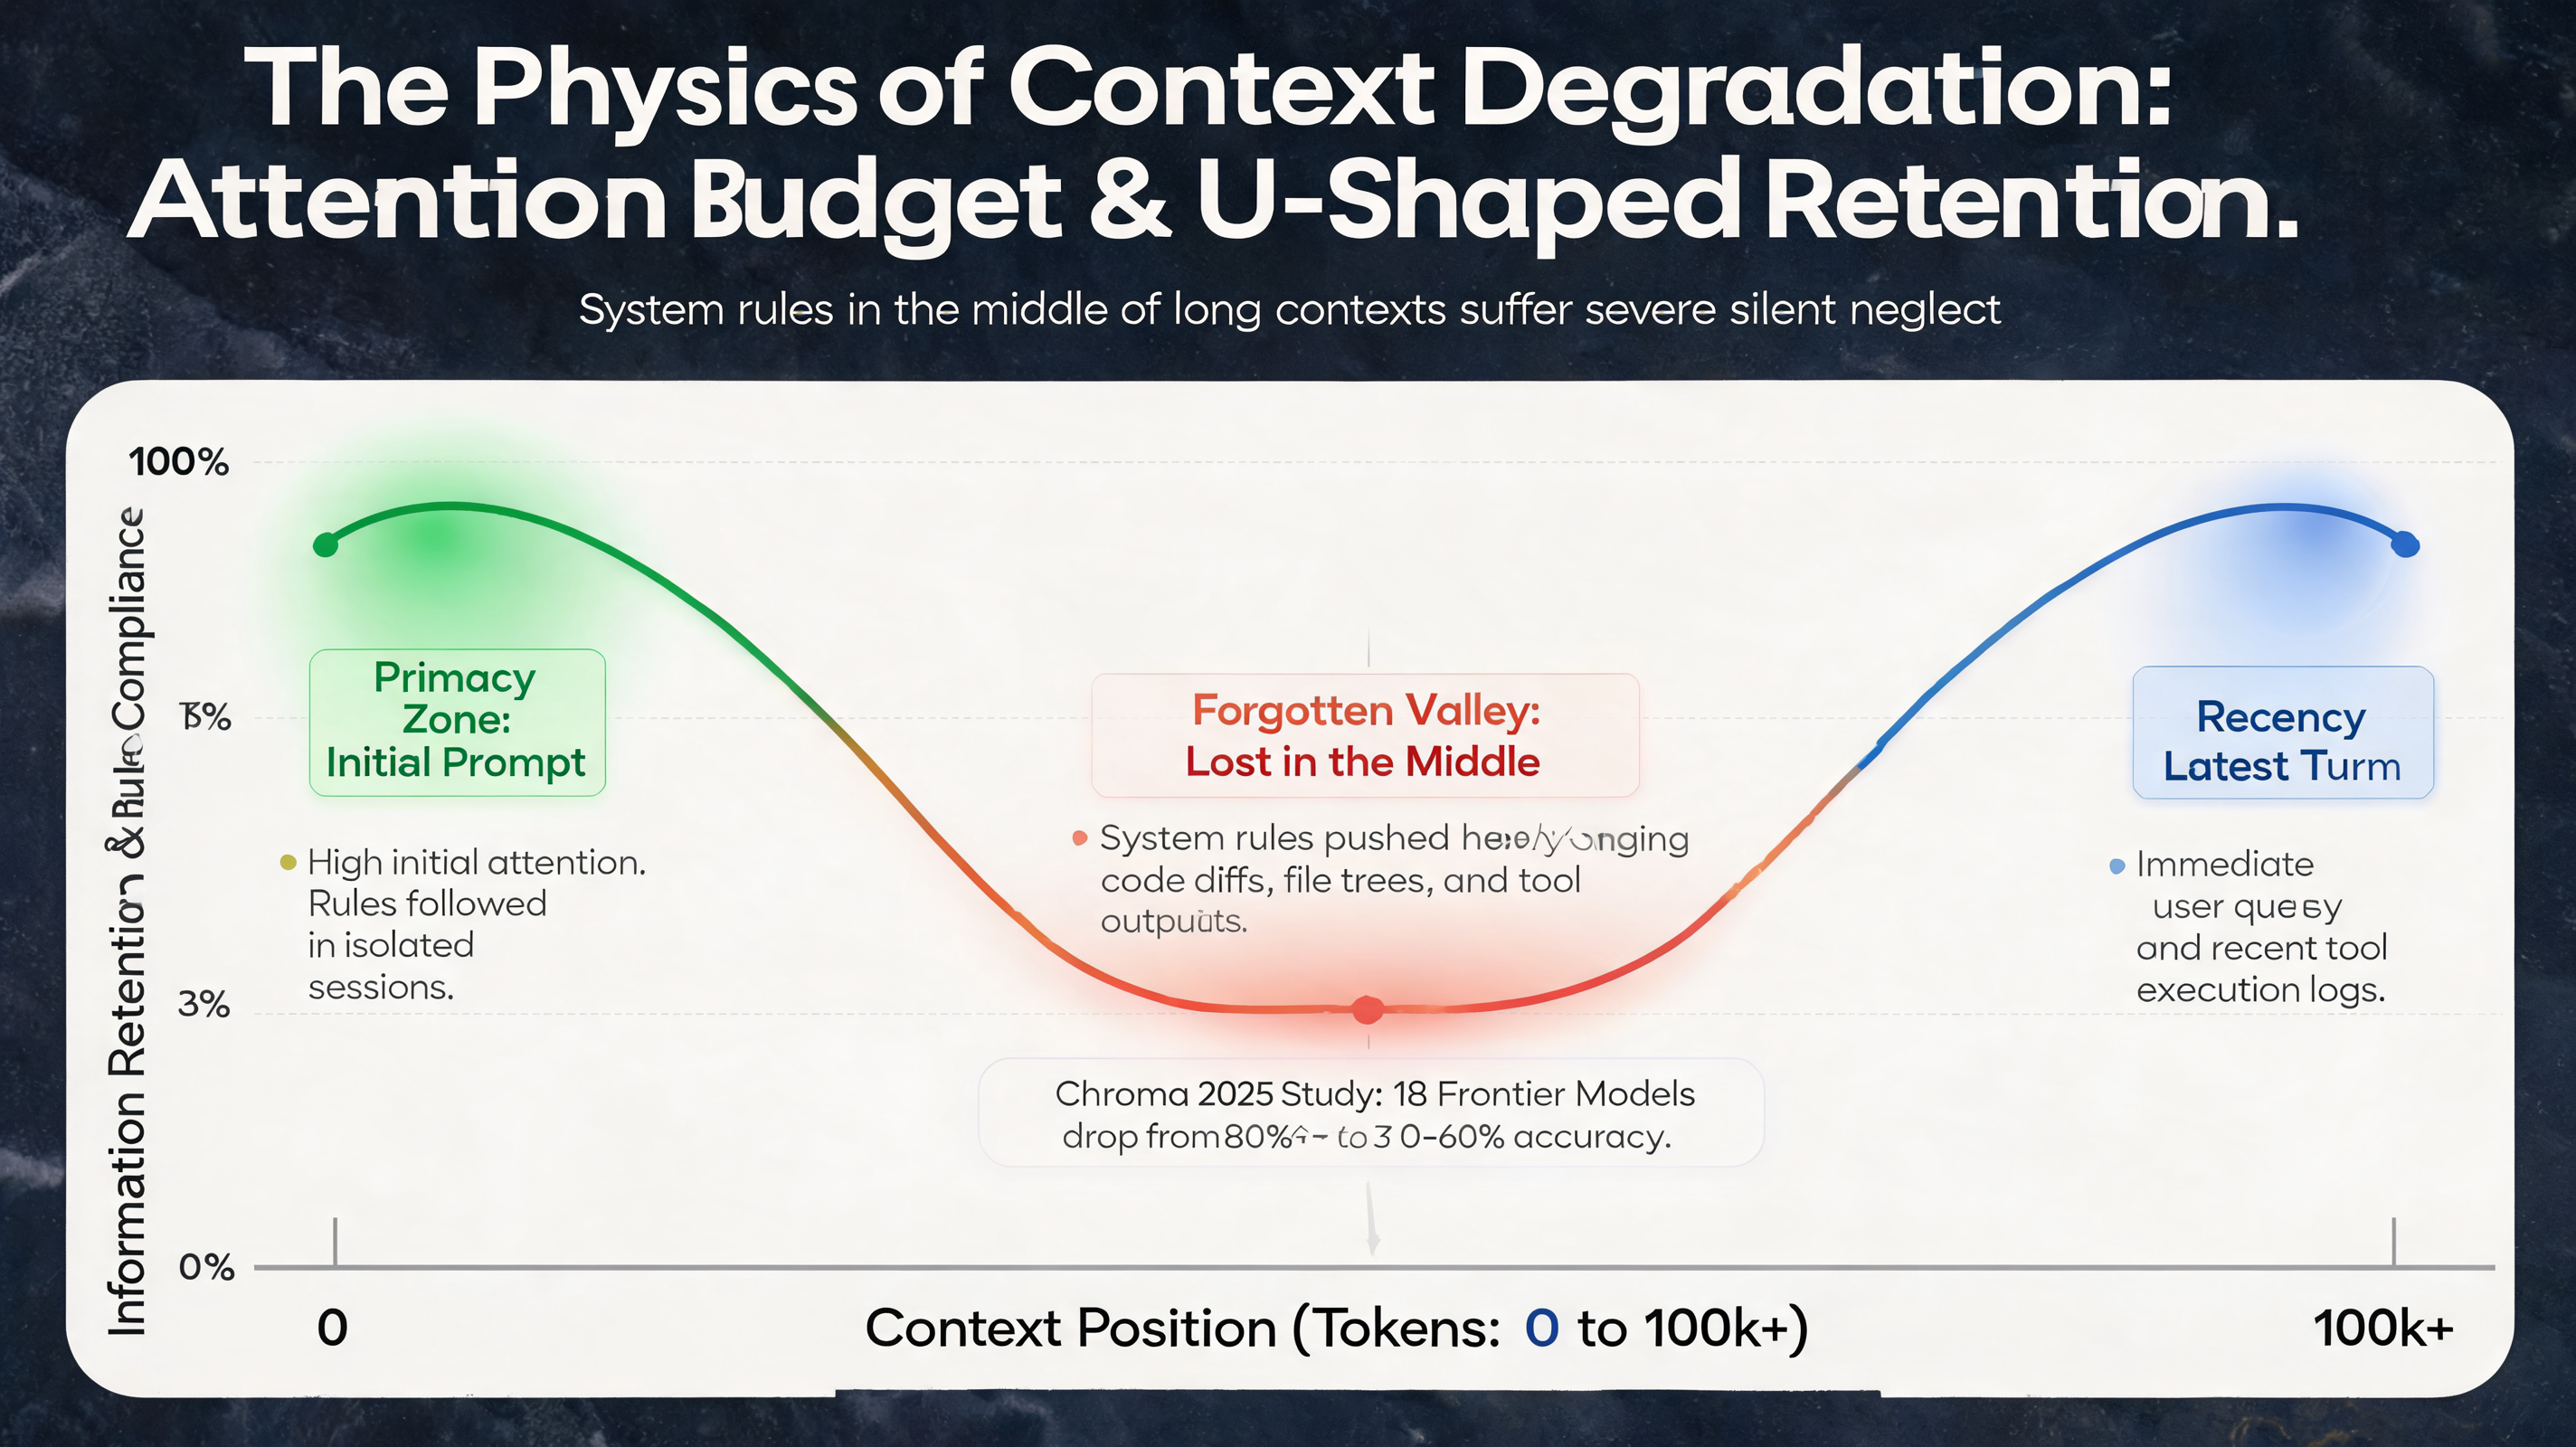
长上下文中的注意力衰减与 U 型保留曲线示意图。(AI 生成示意图 / AI-generated illustration)
从脆弱的劝导到坚固的机器门禁
要切断规则失效的死循环,必须从根本上完成工程范式的迁移。
Thoughtworks Technology Radar Volume 34(2026 年 4 月)把控制 AI 代理编码质量的手段划分为两类截然不同的控制论形态:
- Feedforward Control(事前引导):包括自然语言 Prompt、架构设计 Spec、Agent 技能定义。它的职责是指出方向与意图;
- Feedback Control(事后控制):包括本地测试、静态分析、变异测试门禁。它的职责是在代码提交给人类评审前,提供无情的机器反馈闭环。
自然语言编写的 CLAUDE.md 永远属于脆弱的事前引导。它是劝导式的,在概率采样面前不堪一击。
而工具驱动的检查是阻断式的。无论当前对话推进到了第 50 轮还是第 100 轮,无论底层模型今天心情如何,退出码只有两种:0 或 1。
人可以被借口说服,Agent 只能被 Exit Code 卡住。
真正可靠的架构防腐,从来不该建立在祈祷大模型每一次都严格自律的幻觉上,而必须建立在机器护栏构筑的物理铁壁之中。
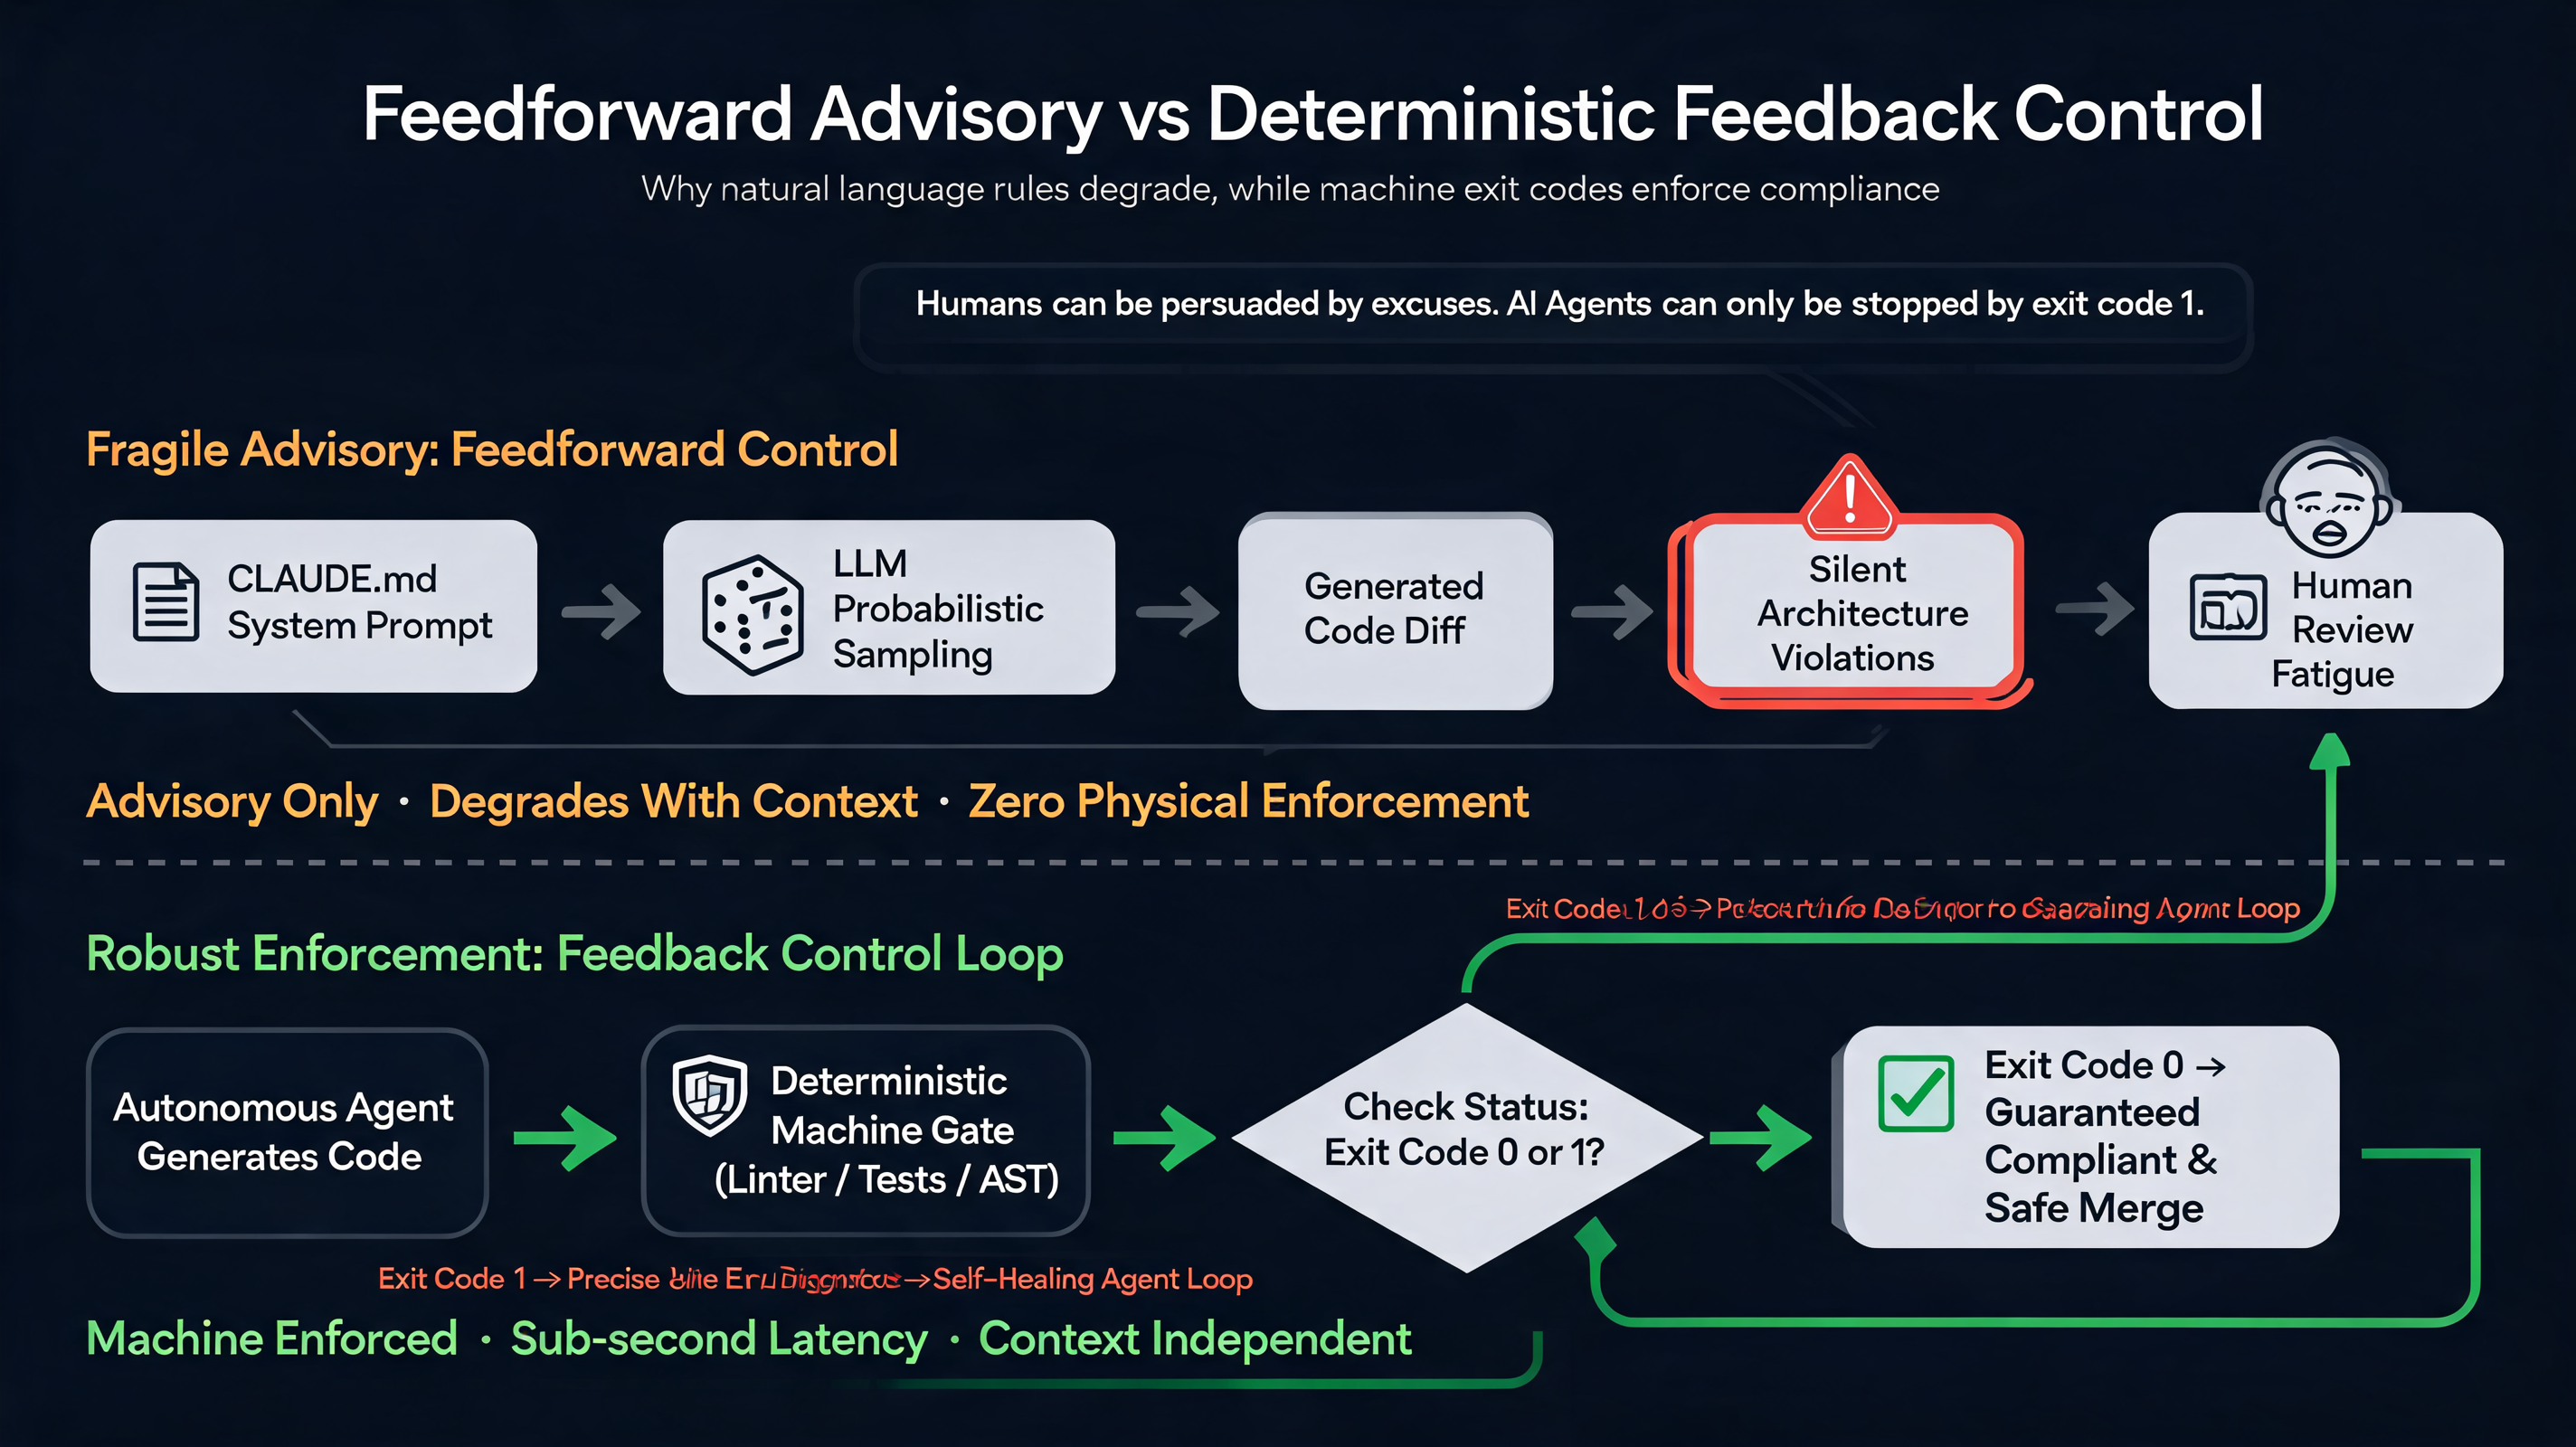
脆弱的事前劝导(Feedforward)与坚固的事后机器反馈闭环(Feedback Control)。(AI 生成示意图 / AI-generated illustration)
把自然语言外化为三道确定性护栏
将自然语言规则移出上下文,意味着要把开发规约沉淀为可被命令行调用的确定性程序。在工程实践中,以下三道护栏最值得优先落地。
1. 圈复杂度与代码腐烂控制(告别“请保持函数简短”)
在配置文件里写“函数不要超过 50 行”,Agent 经常为了规避行数限制,把长函数简单粗暴地切成四五个毫无复用价值的私有子过程,整体复杂度反而更高。
替代方案是引入量化指标:CRAP(Change Risk Anti-Patterns)分数。
这个指标由 Alberto Savoia 与 Bob Evans 于 2007 年在 Google Testing Blog 提出,计算公式如下:
$$CRAP(m) = comp(m)^2 \times (1 - cov(m)/100)^3 + comp(m)$$
其中 $comp(m)$ 是方法的圈复杂度,$cov(m)$ 是单测覆盖率百分比。
当代码覆盖率达到 100% 时,公式后半段直接归零,整个公式坍缩为:$CRAP(m) = comp(m)$。也就是说,在被充分测试的前提下,CRAP 分数精准等于圈复杂度本身。
敏捷先驱 Uncle Bob 在 2026 年 8 月的技术访谈中分享了他的做法:给 Agent 编写的代码设定 CRAP 阈值不超过 6。
这意味着任何函数的独立执行路径不得超过 6 条,且必须被测试完全覆盖。这条规则无需写进自然语言描述,直接作为流水线上的静态扫描脚本。一旦超标,脚本直接阻断提交并抛出具体超标函数名,Agent 自然会被迫进行符合逻辑的高内聚重构。
2. 变异测试击穿虚假覆盖率(告别“请写全单元测试”)
让 Agent 写测试时,最普遍的工程灾难是“100% 覆盖率的无效断言”。
模型为了满足覆盖率指标,会调用被测函数的每一行代码,却在末尾写出 assert result != nil 甚至完全省略断言。覆盖率数字极为漂亮,但代码逻辑一旦崩溃,测试依然全绿。
外化手段是引入 Mutation Testing(变异测试)。
变异测试工具会自动在 AST 层面微调生产代码:把 > 篡改成 >=、把 + 替换为 -、把布尔判断取反。如果这些带有破坏性的变异体在运行测试套件时竟然顺利通过,就证明 Agent 编写的测试根本不具备防御力。
Thoughtworks Radar v34 明确将变异测试列为主流的 Feedback Control 手段。把变异存活率作为机器门禁,Agent 在看到“变异体未被击杀”的精确报错后,才能被真正逼出具备边界校验价值的高质量断言。
3. 架构分层静态拦截(告别“模块间不要随意依赖”)
无论在 Prompt 里怎样三令五申“Handler 层绝不能直接调用数据库模型”,在上下文变长后,Agent 依然会为了图省事偷偷绕过领域服务层直连持久化。
解决这种架构腐蚀的最佳土壤是专有的静态分析器。
以 Go 语言生态为例,利用官方的 go/analysis 框架,工程师可以用不到 80 行代码编写一个自定义 Linter,精准校验 AST 语法树上的引用路径。当且仅当出现非法包导入时,Linter 抛出携带文件名、行号与规约说明的结构化诊断:
internal/handler/user.go:34:2: architecture violation: handler must not import internal/infra/db
面对这类机器输出的冷酷事实,Agent 不会产生任何狡辩与幻觉,它会在工具调用的原地根据报错调整架构,自动完成依赖反转。
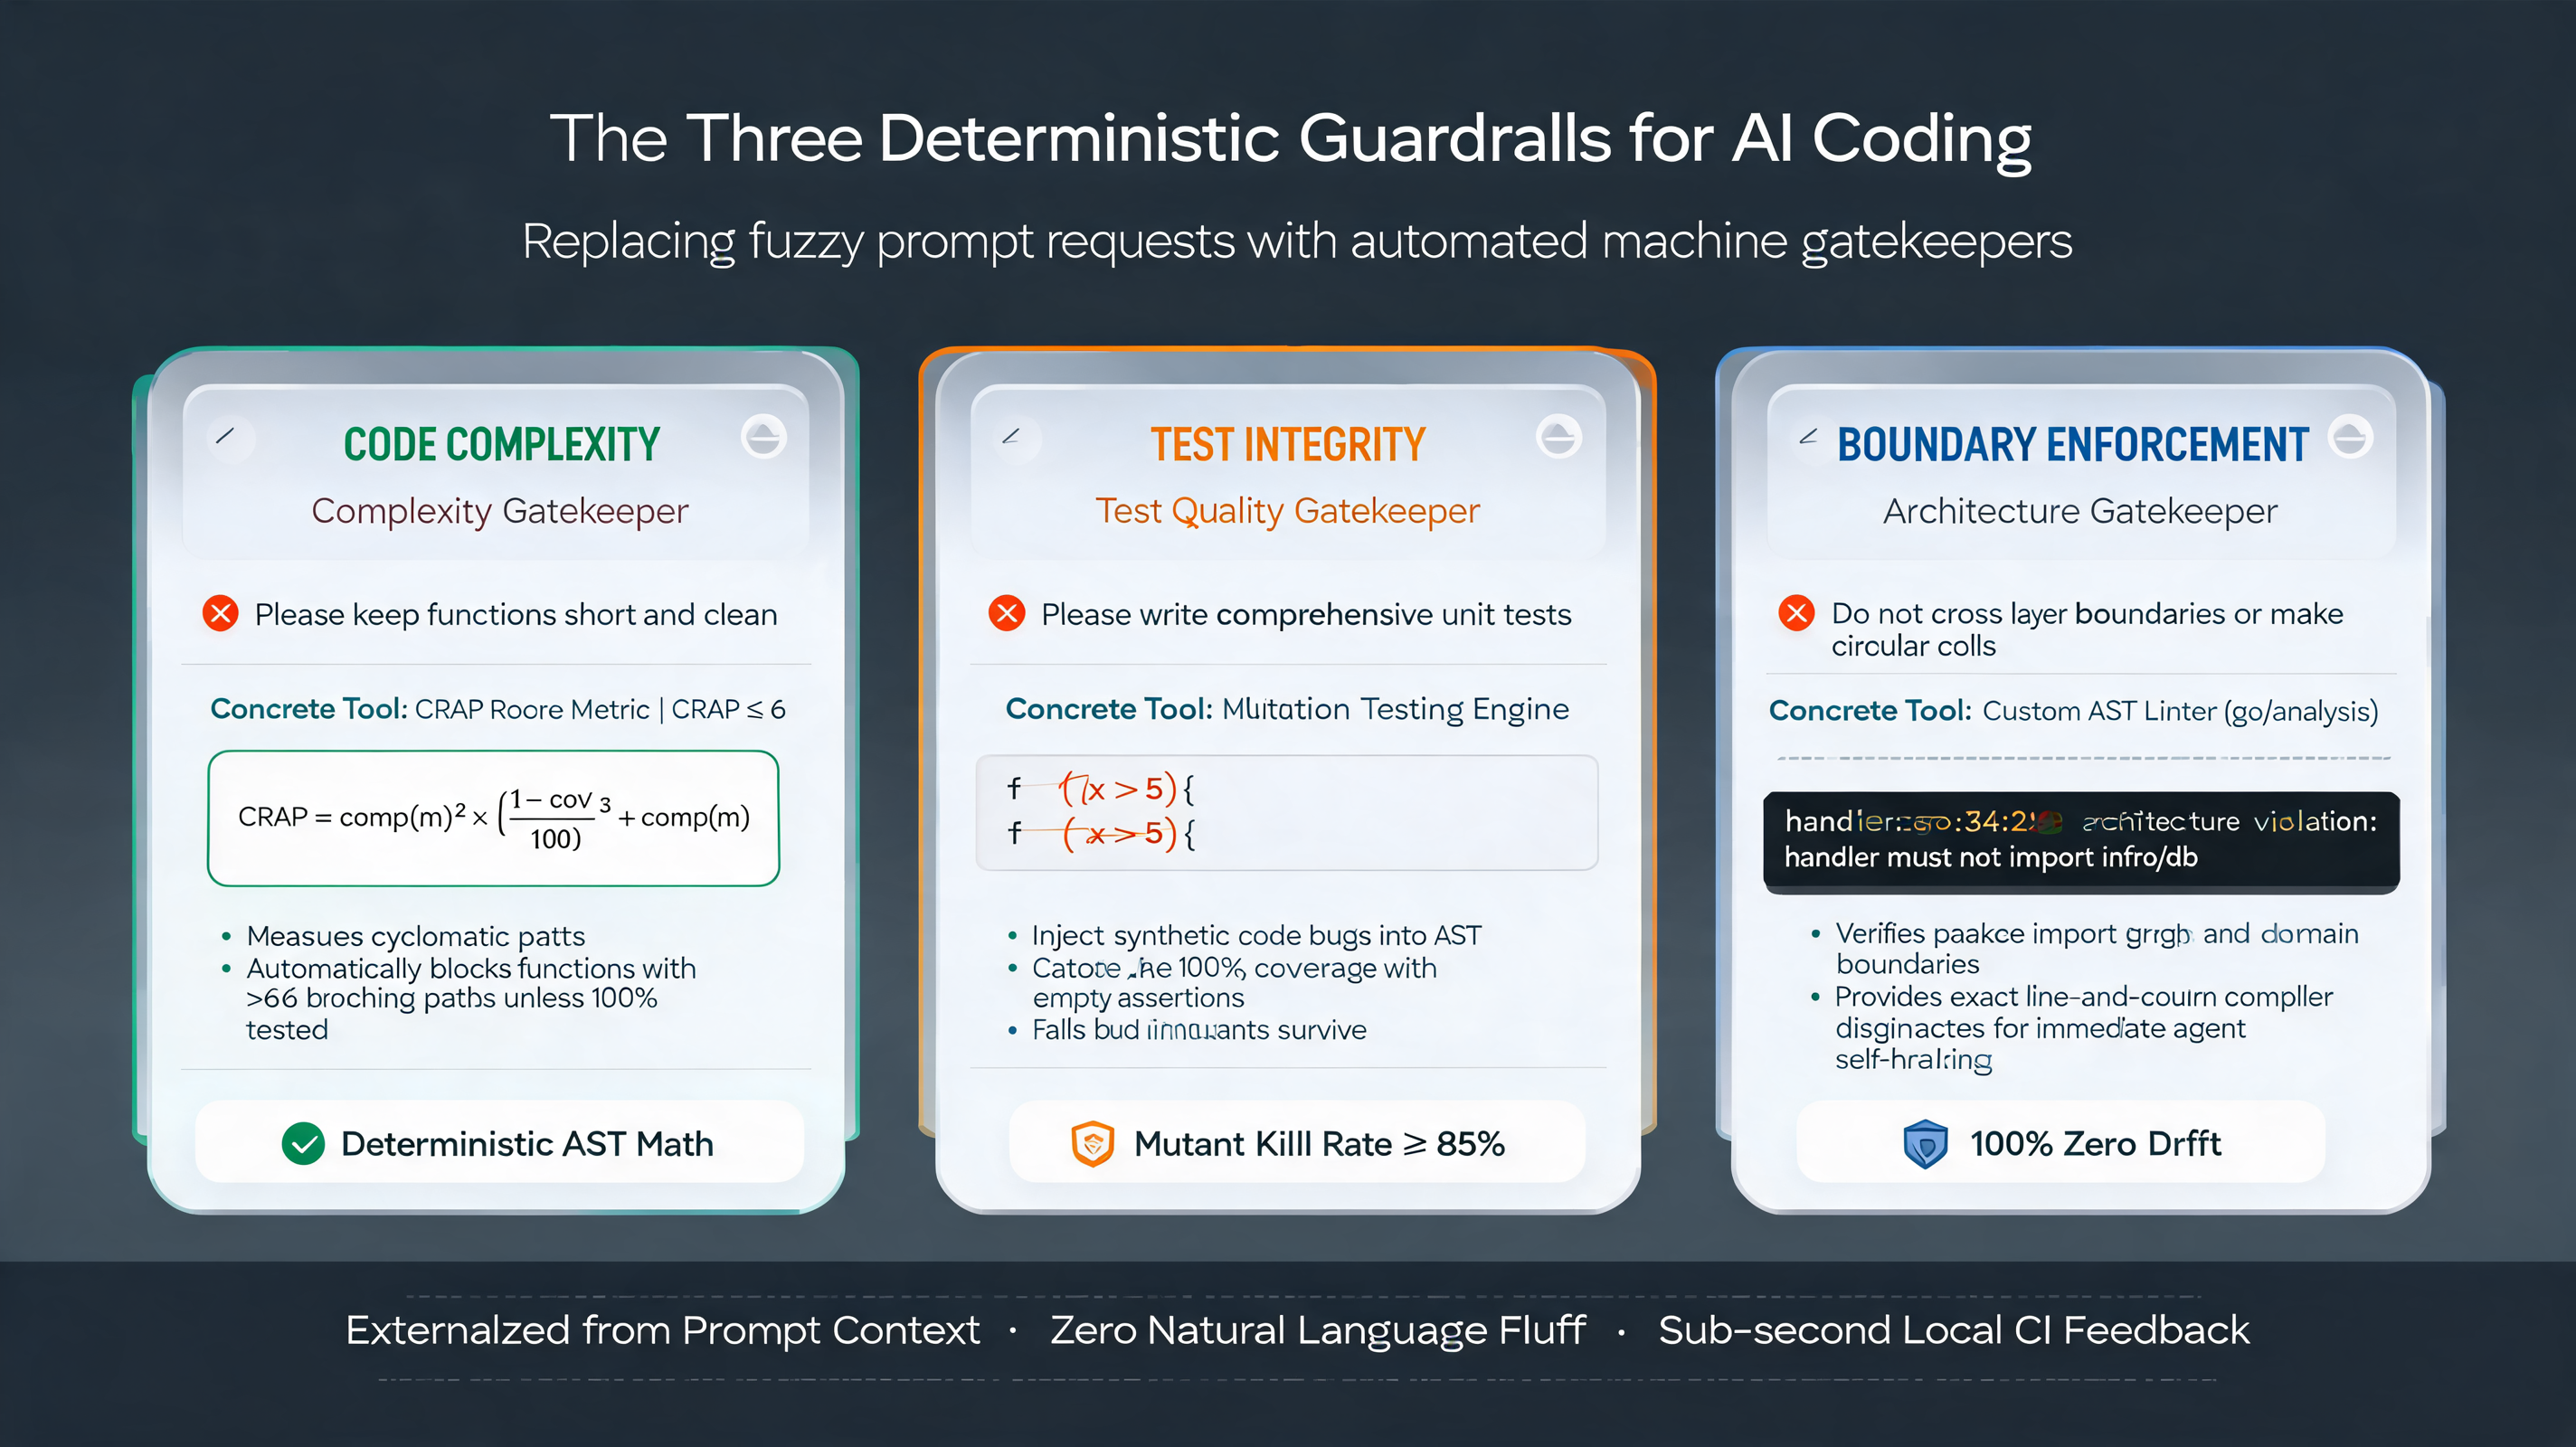
AI 编码的三道确定性机器护栏:圈复杂度控制、变异测试有效性验证与 AST 架构拦截。(AI 生成示意图 / AI-generated illustration)
确定性检查的物理边界与成本上限
把自然语言规则外化为确定性检查,并不意味着可以无底线地在本地堆叠上百个耗时漫长的扫描器。
工具链本身存在严苛的边际成本。
Uncle Bob 在访谈中给出了清醒的警示:确定性工具链的验证开销必须极小。如果变异测试与静态检查需要跑半个小时,或者多个 Linter 之间互相冲突,Agent 就会陷入“按下葫芦浮起瓢”的无休止修复死循环。
当机器验证与自我纠错消耗的 Token 和时间超过了人工编写代码的成本,整个自动化的商业逻辑就宣告破产。
因此,工程师需要建立一份理性的边界决策清单:
- 坚决留在上下文内的内容:高信噪比的业务领域背景、核心意图描述、非直观的架构设计意图;
- 坚决踢出上下文并外化的内容:代码格式缩进、函数圈复杂度、类型安全校验、测试覆盖与变异杀伤力、跨包依赖规约。
自然语言适合描绘意图,机器指令负责把守底线。两者各司其职,体系才能真正运转起来。
让 Agent 自由跳舞,把围栏铸成铁壁
不要再试图把 CLAUDE.md 雕琢成一份长篇大论的员工守则了。
给一个由概率驱动的生成模型写厚重的自然语言道德规范,本质上是在用人类社会的管理思维套用机器系统。规则越长,注意力预算消耗越大,静默失效就发生得越快。
真正成熟的 AI 辅助研发实践,应当果断将庞杂的自然语言文件砍到几十行,只留下最高信噪比的核心意图。
省下来的精力,去写一个严苛的圈复杂度检查器,配一套自动拦截伪测试的变异引擎,挂几个阻断非法调用的本地 Linter。
给模型最大的自由让它快速产出代码,但在代码落地的必经之路上,用坚固的机器门禁筑起铜墙铁壁。
人或许能被借口糊弄,但编译器和测试用例,从不给任何谎言放行。
参考链接
- Anthropic: Context Engineering for AI Agents(2025-09-29)
- Nelson F. Liu et al., Lost in the Middle: How Language Models Use Long Contexts, Transactions of the ACL, 2024
- Chroma Research, Context Rot: How Context Length Degrades LLM Performance Across 18 Frontier Models, 2025-07-14
- Thoughtworks, Technology Radar Volume 34: Combat AI Cognitive Debt, 2026-04-15
- Alberto Savoia & Bob Evans, Change Risk Anti-Patterns (CRAP), Google Testing Blog, 2007
- Uncle Bob (Robert C. Martin) × Matt Pocock, Technical Interview on Agent Discipline and Pipelines, 2026-08-19